
在网上购物、整理房间、进行科学实验等任务中,AI Agent 往往需要连续做出许多决策:理解目标、观察环境、选择动作,再根据反馈调整下一步。任务越长,早期的一次判断失误,就越可能让后续执行逐渐偏离目标。
大模型通常具备更强的任务规划和纠错能力,但运行成本较高;小模型部署更快、更便宜,却更容易在长程任务中“越做越偏”。如何把大模型的能力有效教给小模型,同时避免大模型不必要地全程接管,是当前 Agent 训练和部署中的重要问题。
针对这一挑战,IDEA 研究院联合香港中文大学、亿道研究院提出了智能体在线策略蒸馏方法 DASH-OPD。这项工作让教师模型能够根据学生模型的实际表现,动态判断何时介入、何时退出,并在学生恢复状态后及时交还控制权。
在 WebShop、ALFWorld 和 ScienceWorld 三大 Agent 基准、两种学生模型规模下,DASH-OPD 在论文报告的 14 项性能指标中全面优于所比较的基线方法,部分任务表现甚至超过教师模型。同时,它还减少了平均交互轮数和回复 Token,为更高效地部署长程 AI Agent 提供了新的路径。DASH-OPD 有着更高的任务表现,更低的执行开销。
DASH-OPD
三大基准、两种模型规模下全面领先
研究团队以 Qwen3-30B-A3B 作为教师模型,训练 Qwen3-1.7B 和 Qwen3-4B 两种学生模型,并在 WebShop、ALFWorld、ScienceWorld 三个长程 Agent 基准上进行评测。
研究将 DASH-OPD 普通 OPD [1]、AdaSwitch [2]、TCOD [3]、Guided-OPD [4]、TurnOPD [5] 相比,DASH-OPD 在三大基准上的性能表现全面领先。
DASH-OPD 的部分性能表现甚至超过了教师模型:WebShop 中两种学生分别高出教师 2.86 分和 2.10 分;ALFWorld 中 4B 学生的总体成功率达到 41.24%,超过教师的 40.88%。另外,在与五个基线的 10 项平均交互轮数的比较中,DASH-OPD 有 9 项获得第一、1 项第二,展现出良好的部署效率。
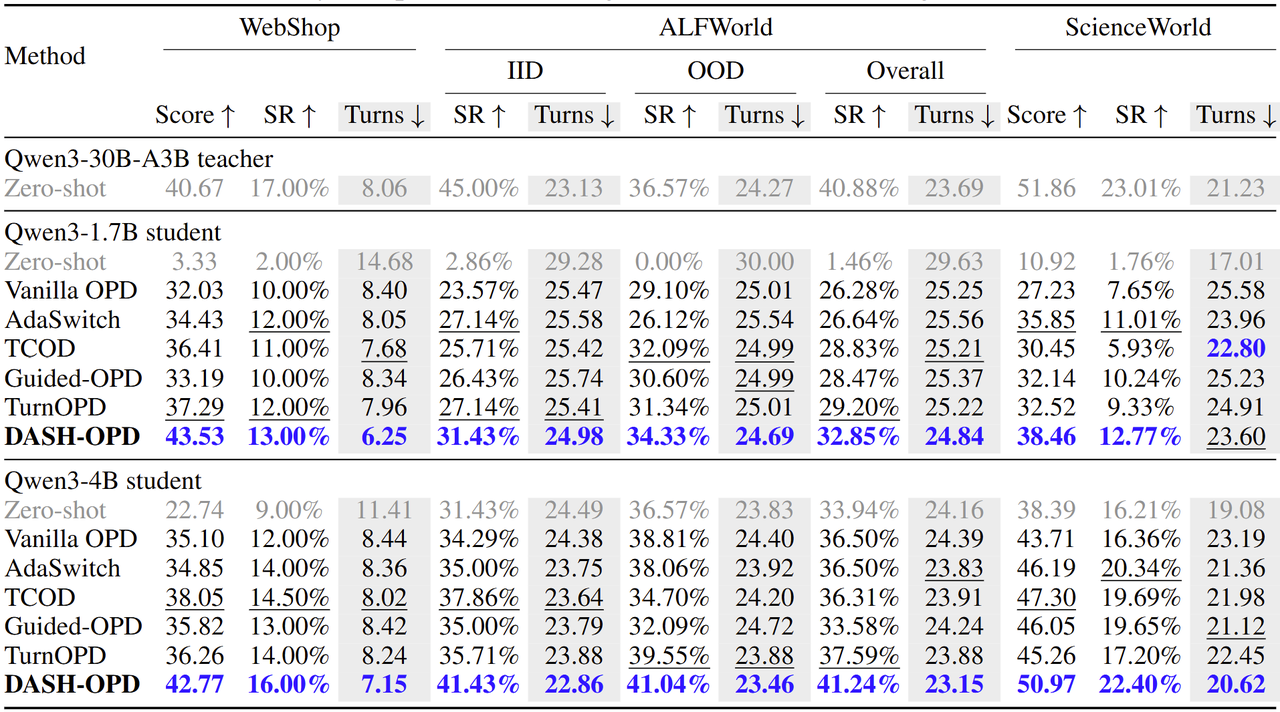
三大基准、两种模型规模下的任务表现与部署效率比较。
Score 为得分,SR 为成功率,均越高越好;Turns 为平均交互轮数,越少越好。蓝色粗体表示同规模最优,下划线表示次优;灰色数据仅作参考不参与排名。
AI Agent 的难点
在于能不能“连续做对”
传统聊天机器人通常只需要针对一个问题生成一次回答,而 AI Agent 面对的往往是一个需要多步完成的任务。例如:
– 在 WebShop 中,根据用户要求搜索并选择合适的商品;
– 在 ALFWorld 中,在家庭环境中移动、寻找和操作物体;
– 在 ScienceWorld 中,在虚拟实验室里按照目标完成一系列科学操作。
这些任务都有一个共同特点:每一步都会影响后续状态。搜索条件理解错了,可能导致后面选择错误商品;物体位置判断错了,可能让整个家务任务无法继续;实验步骤顺序不对,也可能最终无法达到目标。
因此,Agent 的能力不仅体现在某一步是否做得正确,还体现在能否在较长的执行过程中持续保持方向正确、及时发现问题并完成任务。
大模型可以当老师
但“何时帮忙”不容易判断
在普通知识蒸馏中,学生模型在训练时只见过人类或者教师生成的上下文,但在部署时却要面对自己产生的上下文。这种训推不一致被称为暴露偏差。OPD 可以有效缓解暴露偏差:它先让学生自己回答,再让教师对这些回答进行打分,并根据教师打分修改学生权重,将教师的能力蒸馏给学生。
但在长程 Agent 任务中,学生的早期错误会让轨迹偏离教师熟悉的领域,进而影响教师的监督质量。因此可以让教师在训练中介入 Rollout(即智能体的一次任务执行轨迹),以提升轨迹质量。
平衡教师介入和学生自主行动是关键:如果教师介入太少,学生一旦走偏,就可能持续在错误的状态中执行,后续动作越来越难以纠正。另一方面,如果教师几乎每一步都接管,虽然任务可能更稳定,但学生缺少独立练习的机会,推理成本也会明显增加。
为什么不能一有分歧
就立刻切换?
知识蒸馏可以理解为让小模型向大模型学习。但看过老师的正确演示,不代表学生自己动手时也能顺利完成任务。
在线策略蒸馏(On-Policy Distillation,OPD)让学生在自己生成的轨迹上学习,老师针对学生实际遇到的上下文提供监督,从而缓解训练与推理场景的错位。然而,在长程 Agent 任务里,学生的错误可能持续累积,把轨迹带到教师也不熟悉的上下文,削弱监督效果。例如,ScienceWorld 中的 4B 学生初始成功率为 16.21%,经普通 OPD 训练后仅提升至 16.36%。因此,如何让蒸馏真正有效,仍是关键挑战。
为解决这一挑战,可以让老师接手几轮,把学生带回正轨;但也不能介入太多,否则学生又失去了自己练习的机会。TCOD [3]、Guided-OPD [4] 等方法主要通过预设的课程安排教师介入,难以根据轨迹中的实际困难决定切换时机。
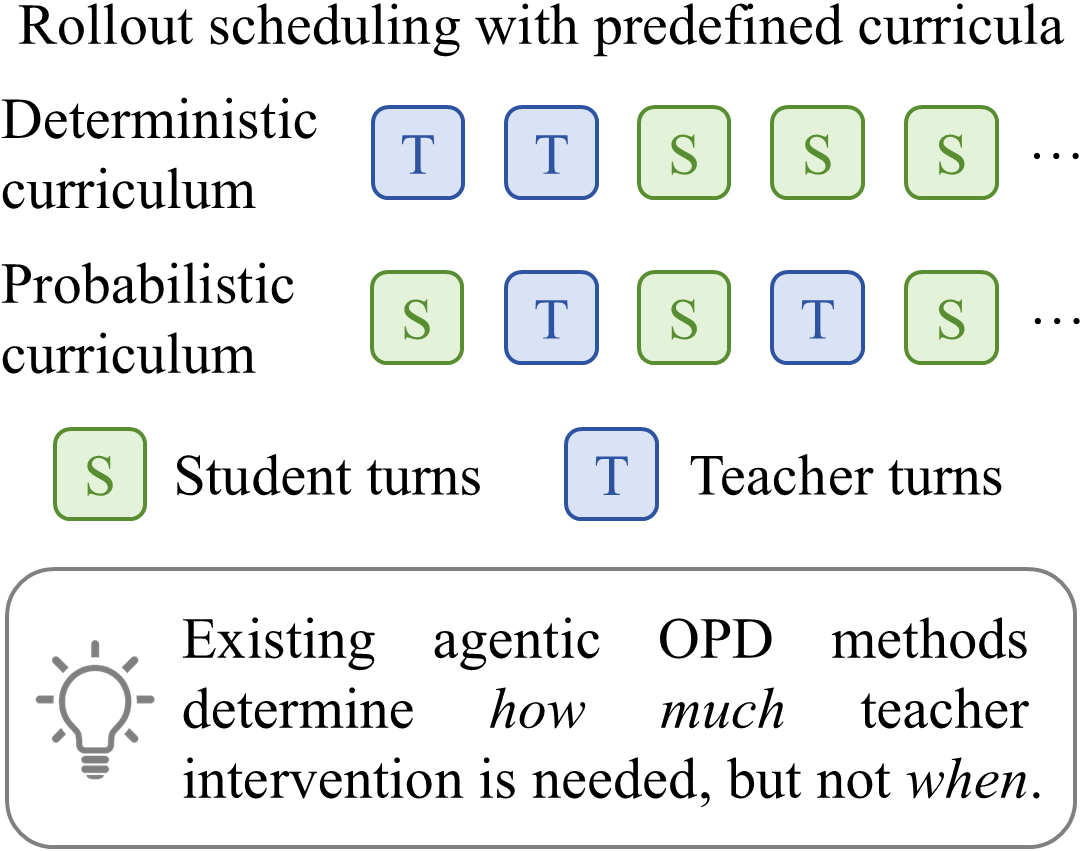
现有方法的研究缺口。上方为确定性课程,下方为概率式课程。
两种课程仅调节老师介入多少,而无法判断何时需要老师。
DASH-OPD
懂分歧,让接管与交还都有依据
DASH-OPD 的核心机制可以概括为三步:观察分歧、累积证据、双向切换。
在每一轮执行中,当前负责行动的模型会生成回复,另一个模型则对其中的动作进行评估。系统通过比较师生对动作的判断差异,估计学生是否正在偏离教师认为更合理的执行方向。
当学生执行任务时,DASH-OPD 关注学生是否出现持续偏离:
– 如果学生的动作与教师判断存在较大差异,系统会记录偏离信号;
– 如果这种差异在多轮中持续出现,偏离证据会逐渐累积;
– 当累积证据超过设定阈值时,教师模型接管执行。
当教师正在执行时,系统会反向判断学生是否已经能够跟上:
– 如果教师与学生之间的分歧逐渐减小,系统会积累恢复信号;
– 当恢复证据达到交还条件时,控制权重新交给学生。
这意味着,DASH-OPD 不只是让教师在必要时“救场”,还会在学生恢复状态后主动“放手”。一次波动,不一定就要换模型。跨轮累积带来的迟滞切换机制抑制了短暂分歧引发的频繁切换。学生持续重复动作或观察时,DASH-OPD 还会触发停滞接管,避免其原地打转。
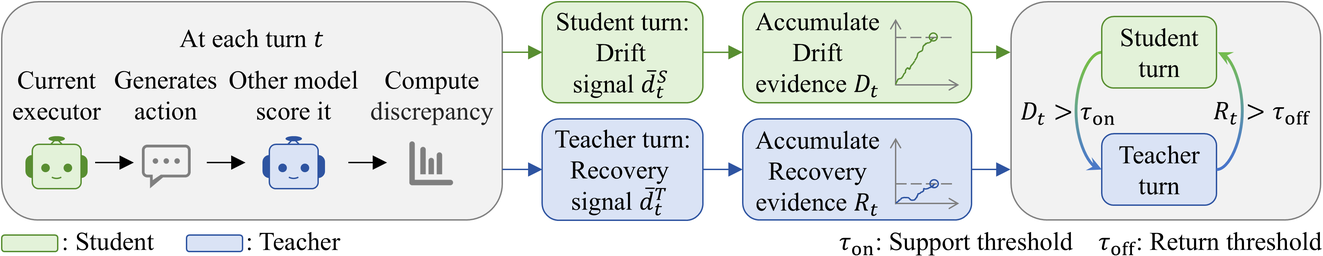
DASH-OPD 的分歧感知与迟滞切换流程
绿色路径积累偏离证据,蓝色路径积累恢复证据,
分别决定教师介入与学生恢复执行
更高的任务表现
更低的执行开销
DASH-OPD 的价值不仅体现在任务得分上,也体现在部署效率上。
在 WebShop 中,1.7B 学生模型平均每个任务输出 619.24 个 Token,比教师模型少 127.37 个 Token,但任务得分反而高出 2.86 分。
也就是说,在这一评测设置下,学生模型并不是通过生成更多内容来换取更高成绩,而是在较少输出的情况下完成了更有效的任务执行。
对于实际部署而言,减少回复 Token 通常意味着更低的推理开销和更快的响应速度。尤其是在需要并发运行大量 Agent,或希望将模型部署在资源受限设备上的场景中,这种效率提升具有现实意义。
需要强调的是,论文报告的是 Token 数和交互轮数等效率指标,并不直接等同于具体金额上的成本下降。但这些结果表明,DASH-OPD 有助于减少大模型不必要的参与,为低成本部署 Agent 提供了潜在空间。
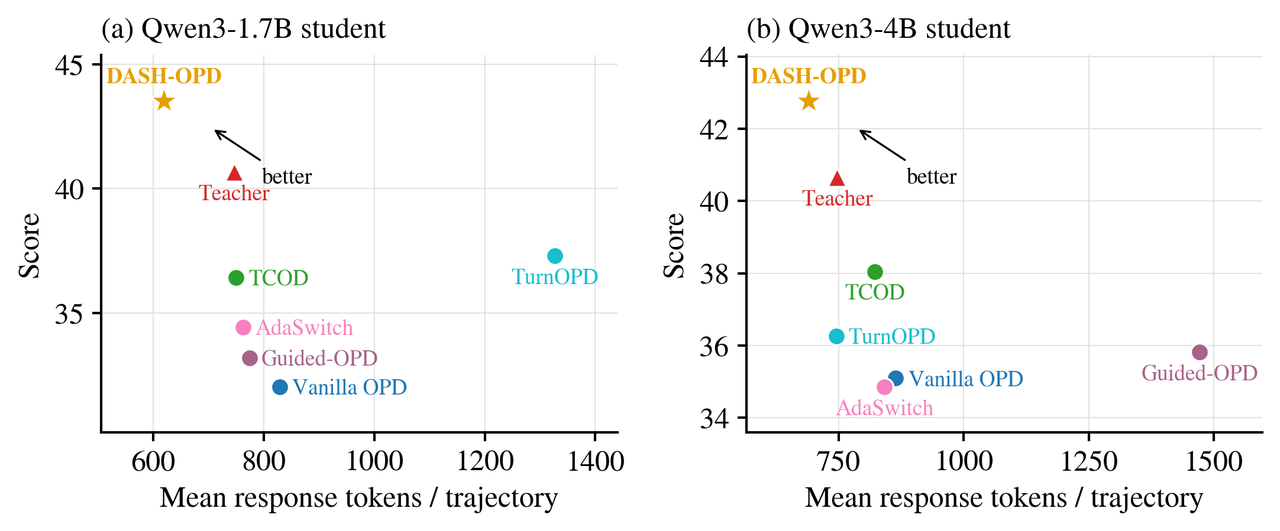
WebShop 上任务得分与平均回复 Token 数的比较。
越靠左上,表示输出更少、得分更高。DASH-OPD 在两种模型规模下均优于所有基线与教师。
核心机制有效
切换阈值稳健
消融实验进一步验证了核心机制。 分别禁用教师介入、向学生交还控制权、或跨轮信号累积,都会降低最终的性能表现。
跨两种模型规模,在 WebShop 上可下降 7.03—11.50 分,在 ScienceWorld 上可下降 4.05—11.23 分,在 ALFWorld 上的总体成功率可下降 4.02—6.57 个百分点。
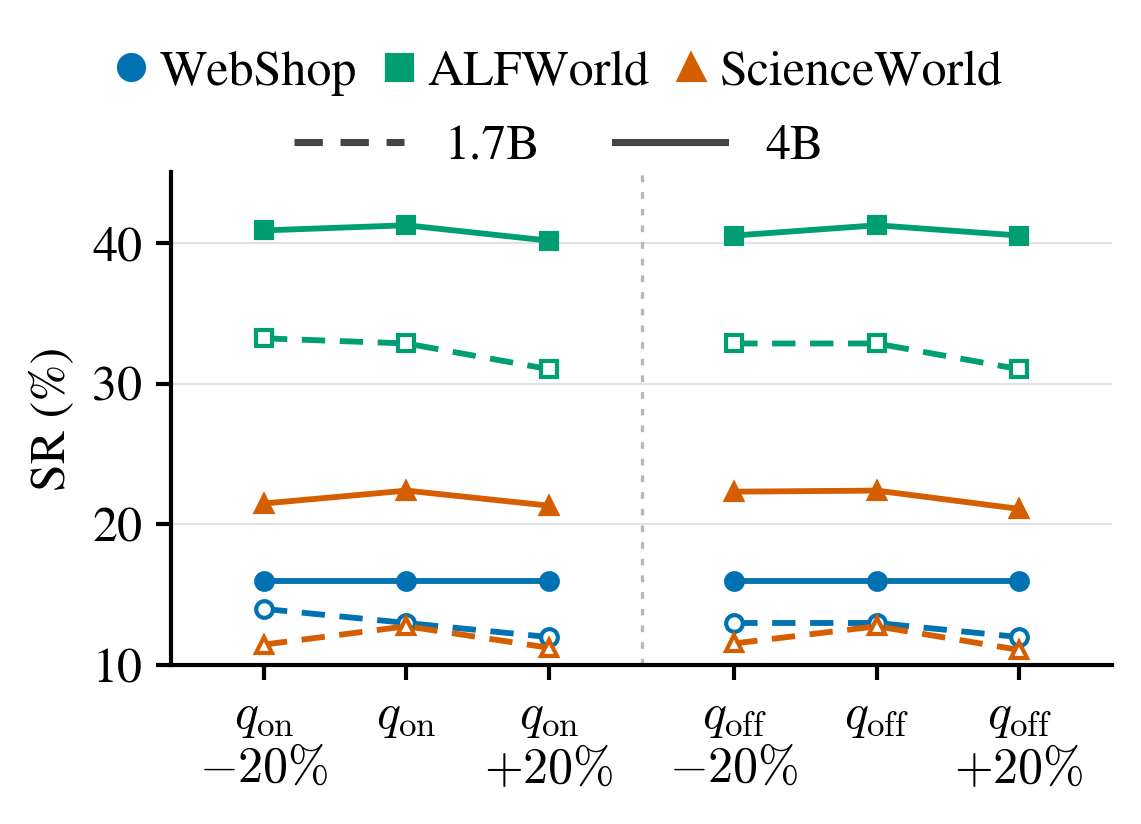
切换阈值敏感性分析。
分别将介入阈值与交还阈值上下调整 20%,另一个保持不变。纵轴为成功率。
切换阈值动一动,性能会不会明显下滑? 在三大基准、两种模型规模下,相比默认设置,分别将两个阈值上下调整 20%,成功率变化最多仅为 1.82 个百分点。其中,WebShop 的 4B 学生在各次扰动下均保持 16.00% 的成功率。这说明 DASH-OPD 对切换阈值的变化具有一定稳健性。
从“模型接力”走向“能力迁移”
长程 Agent 的训练,不能只追求某一次任务是否完成,还需要考虑模型是否真正获得了独立执行能力。
DASH-OPD 所探索的,正是教师模型与学生模型之间更灵活的协作方式:教师不再按照固定课程机械介入,而是根据学生在当前任务中的实际状态做出判断;学生也不再只是被动接受指导,而是在大部分时间里保持自主执行,并在需要时获得帮助。
从研究角度看,这项工作将师生分歧感知、跨轮证据累积和双向控制切换引入 Agentic OPD,为长程智能体的在线策略蒸馏提供了一种新的方法框架。
从工程角度看,它显示出同时提升任务效果与执行效率的潜力:让更小的模型承担更多工作,将大模型的能力转化为更便宜、更灵活的 Agent 执行方案。
在长程 Agent 基准上,研究结果展示了一种值得关注的方向:大模型不必始终替小模型完成任务,在需要时接管,在跟得上时放手,把训练中的帮助转化为学生独立执行的能力。
论文: arXiv:2607.29078
代码、模型与训练日志: github.com/Lucian1115/DASH-OPD
作者: Yuchen Xia、Qianguo Sun、Chao Song、Junlong Wu、Yiyan Qi、Yunjian Xu
参考文献
[1] R. Agarwal, N. Vieillard, Y. Zhou, P. Stanczyk, S. Ramos Garea, M. Geist, and O. Bachem, “On-policy distillation of language models: Learning from self-generated mistakes,” in International Conference on Learning Representations, vol. 2024, 2024, pp. 21 246–21 263.
[2] J. Peng, M. Wang, H. Cai, Y. Li, K. Zhang, S. Wang, D. Yin, and X. Zhao, “Adaswitch: Balancing exploration and guidance in knowledge distillation via adaptive switching,” arXiv preprint arXiv:2510.07842, 2025.
[3] J. Wang, W. Zhang, W. Shi, Y. Li, and J. Cheng, “Tcod: Exploring temporal curriculum in on-policy distillation for multi-turn autonomous Agents,” arXiv preprint arXiv:2604.24005, 2026.
[4] G. Li, M. Zheng, M. Song, R. Liu, T. Yang, J. Sun, Q. Zhong, H. Guo, J. Fang, D. Zhang et al., “On-policy distillation with curriculum turn-level guidance for multi-turn Agents,” arXiv preprint arXiv:2606.15912, 2026.
[5] Y. Zhou, K. Zheng, H. Li, D. Peng, C. Xu, and J. Chen, “Turnopd: Making on-policy distillation turn-aware for efficient long-horizon Agent training,” arXiv preprint arXiv:2607.05804, 2026.
在网上购物、整理房间、进行科学实验等任务中,AI Agent 往往需要连续做出许多决策:理解目标、观察环境、选择动作,再根据反馈调整下一步。任务越长,早期的一次判断失误,就越可能让后续执行逐渐偏离目标。
大模型通常具备更强的任务规划和纠错能力,但运行成本较高;小模型部署更快、更便宜,却更容易在长程任务中“越做越偏”。如何把大模型的能力有效教给小模型,同时避免大模型不必要地全程接管,是当前 Agent 训练和部署中的重要问题。
针对这一挑战,IDEA 研究院联合香港中文大学、亿道研究院提出了智能体在线策略蒸馏方法 DASH-OPD。这项工作让教师模型能够根据学生模型的实际表现,动态判断何时介入、何时退出,并在学生恢复状态后及时交还控制权。
在 WebShop、ALFWorld 和 ScienceWorld 三大 Agent 基准、两种学生模型规模下,DASH-OPD 在论文报告的 14 项性能指标中全面优于所比较的基线方法,部分任务表现甚至超过教师模型。同时,它还减少了平均交互轮数和回复 Token,为更高效地部署长程 AI Agent 提供了新的路径。DASH-OPD 有着更高的任务表现,更低的执行开销。
DASH-OPD
三大基准、两种模型规模下全面领先
研究团队以 Qwen3-30B-A3B 作为教师模型,训练 Qwen3-1.7B 和 Qwen3-4B 两种学生模型,并在 WebShop、ALFWorld、ScienceWorld 三个长程 Agent 基准上进行评测。
研究将 DASH-OPD 普通 OPD [1]、AdaSwitch [2]、TCOD [3]、Guided-OPD [4]、TurnOPD [5] 相比,DASH-OPD 在三大基准上的性能表现全面领先。
DASH-OPD 的部分性能表现甚至超过了教师模型:WebShop 中两种学生分别高出教师 2.86 分和 2.10 分;ALFWorld 中 4B 学生的总体成功率达到 41.24%,超过教师的 40.88%。另外,在与五个基线的 10 项平均交互轮数的比较中,DASH-OPD 有 9 项获得第一、1 项第二,展现出良好的部署效率。
三大基准、两种模型规模下的任务表现与部署效率比较。
Score 为得分,SR 为成功率,均越高越好;Turns 为平均交互轮数,越少越好。蓝色粗体表示同规模最优,下划线表示次优;灰色数据仅作参考不参与排名。
AI Agent 的难点
在于能不能“连续做对”
传统聊天机器人通常只需要针对一个问题生成一次回答,而 AI Agent 面对的往往是一个需要多步完成的任务。例如:
– 在 WebShop 中,根据用户要求搜索并选择合适的商品;
– 在 ALFWorld 中,在家庭环境中移动、寻找和操作物体;
– 在 ScienceWorld 中,在虚拟实验室里按照目标完成一系列科学操作。
这些任务都有一个共同特点:每一步都会影响后续状态。搜索条件理解错了,可能导致后面选择错误商品;物体位置判断错了,可能让整个家务任务无法继续;实验步骤顺序不对,也可能最终无法达到目标。
因此,Agent 的能力不仅体现在某一步是否做得正确,还体现在能否在较长的执行过程中持续保持方向正确、及时发现问题并完成任务。
大模型可以当老师
但“何时帮忙”不容易判断
在普通知识蒸馏中,学生模型在训练时只见过人类或者教师生成的上下文,但在部署时却要面对自己产生的上下文。这种训推不一致被称为暴露偏差。OPD 可以有效缓解暴露偏差:它先让学生自己回答,再让教师对这些回答进行打分,并根据教师打分修改学生权重,将教师的能力蒸馏给学生。
但在长程 Agent 任务中,学生的早期错误会让轨迹偏离教师熟悉的领域,进而影响教师的监督质量。因此可以让教师在训练中介入 Rollout(即智能体的一次任务执行轨迹),以提升轨迹质量。
平衡教师介入和学生自主行动是关键:如果教师介入太少,学生一旦走偏,就可能持续在错误的状态中执行,后续动作越来越难以纠正。另一方面,如果教师几乎每一步都接管,虽然任务可能更稳定,但学生缺少独立练习的机会,推理成本也会明显增加。
为什么不能一有分歧
就立刻切换?
知识蒸馏可以理解为让小模型向大模型学习。但看过老师的正确演示,不代表学生自己动手时也能顺利完成任务。
在线策略蒸馏(On-Policy Distillation,OPD)让学生在自己生成的轨迹上学习,老师针对学生实际遇到的上下文提供监督,从而缓解训练与推理场景的错位。然而,在长程 Agent 任务里,学生的错误可能持续累积,把轨迹带到教师也不熟悉的上下文,削弱监督效果。例如,ScienceWorld 中的 4B 学生初始成功率为 16.21%,经普通 OPD 训练后仅提升至 16.36%。因此,如何让蒸馏真正有效,仍是关键挑战。
为解决这一挑战,可以让老师接手几轮,把学生带回正轨;但也不能介入太多,否则学生又失去了自己练习的机会。TCOD [3]、Guided-OPD [4] 等方法主要通过预设的课程安排教师介入,难以根据轨迹中的实际困难决定切换时机。
现有方法的研究缺口。上方为确定性课程,下方为概率式课程。
两种课程仅调节老师介入多少,而无法判断何时需要老师。
DASH-OPD
懂分歧,让接管与交还都有依据
DASH-OPD 的核心机制可以概括为三步:观察分歧、累积证据、双向切换。
在每一轮执行中,当前负责行动的模型会生成回复,另一个模型则对其中的动作进行评估。系统通过比较师生对动作的判断差异,估计学生是否正在偏离教师认为更合理的执行方向。
当学生执行任务时,DASH-OPD 关注学生是否出现持续偏离:
– 如果学生的动作与教师判断存在较大差异,系统会记录偏离信号;
– 如果这种差异在多轮中持续出现,偏离证据会逐渐累积;
– 当累积证据超过设定阈值时,教师模型接管执行。
当教师正在执行时,系统会反向判断学生是否已经能够跟上:
– 如果教师与学生之间的分歧逐渐减小,系统会积累恢复信号;
– 当恢复证据达到交还条件时,控制权重新交给学生。
这意味着,DASH-OPD 不只是让教师在必要时“救场”,还会在学生恢复状态后主动“放手”。一次波动,不一定就要换模型。跨轮累积带来的迟滞切换机制抑制了短暂分歧引发的频繁切换。学生持续重复动作或观察时,DASH-OPD 还会触发停滞接管,避免其原地打转。
DASH-OPD 的分歧感知与迟滞切换流程
绿色路径积累偏离证据,蓝色路径积累恢复证据,
分别决定教师介入与学生恢复执行
更高的任务表现
更低的执行开销
DASH-OPD 的价值不仅体现在任务得分上,也体现在部署效率上。
在 WebShop 中,1.7B 学生模型平均每个任务输出 619.24 个 Token,比教师模型少 127.37 个 Token,但任务得分反而高出 2.86 分。
也就是说,在这一评测设置下,学生模型并不是通过生成更多内容来换取更高成绩,而是在较少输出的情况下完成了更有效的任务执行。
对于实际部署而言,减少回复 Token 通常意味着更低的推理开销和更快的响应速度。尤其是在需要并发运行大量 Agent,或希望将模型部署在资源受限设备上的场景中,这种效率提升具有现实意义。
需要强调的是,论文报告的是 Token 数和交互轮数等效率指标,并不直接等同于具体金额上的成本下降。但这些结果表明,DASH-OPD 有助于减少大模型不必要的参与,为低成本部署 Agent 提供了潜在空间。
WebShop 上任务得分与平均回复 Token 数的比较。
越靠左上,表示输出更少、得分更高。DASH-OPD 在两种模型规模下均优于所有基线与教师。
核心机制有效
切换阈值稳健
消融实验进一步验证了核心机制。 分别禁用教师介入、向学生交还控制权、或跨轮信号累积,都会降低最终的性能表现。
跨两种模型规模,在 WebShop 上可下降 7.03—11.50 分,在 ScienceWorld 上可下降 4.05—11.23 分,在 ALFWorld 上的总体成功率可下降 4.02—6.57 个百分点。
切换阈值敏感性分析。
分别将介入阈值与交还阈值上下调整 20%,另一个保持不变。纵轴为成功率。
切换阈值动一动,性能会不会明显下滑? 在三大基准、两种模型规模下,相比默认设置,分别将两个阈值上下调整 20%,成功率变化最多仅为 1.82 个百分点。其中,WebShop 的 4B 学生在各次扰动下均保持 16.00% 的成功率。这说明 DASH-OPD 对切换阈值的变化具有一定稳健性。
从“模型接力”走向“能力迁移”
长程 Agent 的训练,不能只追求某一次任务是否完成,还需要考虑模型是否真正获得了独立执行能力。
DASH-OPD 所探索的,正是教师模型与学生模型之间更灵活的协作方式:教师不再按照固定课程机械介入,而是根据学生在当前任务中的实际状态做出判断;学生也不再只是被动接受指导,而是在大部分时间里保持自主执行,并在需要时获得帮助。
从研究角度看,这项工作将师生分歧感知、跨轮证据累积和双向控制切换引入 Agentic OPD,为长程智能体的在线策略蒸馏提供了一种新的方法框架。
从工程角度看,它显示出同时提升任务效果与执行效率的潜力:让更小的模型承担更多工作,将大模型的能力转化为更便宜、更灵活的 Agent 执行方案。
在长程 Agent 基准上,研究结果展示了一种值得关注的方向:大模型不必始终替小模型完成任务,在需要时接管,在跟得上时放手,把训练中的帮助转化为学生独立执行的能力。
论文: arXiv:2607.29078
代码、模型与训练日志: github.com/Lucian1115/DASH-OPD
作者: Yuchen Xia、Qianguo Sun、Chao Song、Junlong Wu、Yiyan Qi、Yunjian Xu
参考文献
[1] R. Agarwal, N. Vieillard, Y. Zhou, P. Stanczyk, S. Ramos Garea, M. Geist, and O. Bachem, “On-policy distillation of language models: Learning from self-generated mistakes,” in International Conference on Learning Representations, vol. 2024, 2024, pp. 21 246–21 263.
[2] J. Peng, M. Wang, H. Cai, Y. Li, K. Zhang, S. Wang, D. Yin, and X. Zhao, “Adaswitch: Balancing exploration and guidance in knowledge distillation via adaptive switching,” arXiv preprint arXiv:2510.07842, 2025.
[3] J. Wang, W. Zhang, W. Shi, Y. Li, and J. Cheng, “Tcod: Exploring temporal curriculum in on-policy distillation for multi-turn autonomous Agents,” arXiv preprint arXiv:2604.24005, 2026.
[4] G. Li, M. Zheng, M. Song, R. Liu, T. Yang, J. Sun, Q. Zhong, H. Guo, J. Fang, D. Zhang et al., “On-policy distillation with curriculum turn-level guidance for multi-turn Agents,” arXiv preprint arXiv:2606.15912, 2026.
[5] Y. Zhou, K. Zheng, H. Li, D. Peng, C. Xu, and J. Chen, “Turnopd: Making on-policy distillation turn-aware for efficient long-horizon Agent training,” arXiv preprint arXiv:2607.05804, 2026.


粤ICP备2020119212号 © 2023年 粤港澳大湾区数字经济研究院版权所有  粤公网安备 44030402006206号